数字人应用正在从概念演示走向实际业务,前台、导购、客服、讲解员都能看到部署案例。但市场扩张的速度,超过了采购方建立判断标准的速度。一个很普遍的情况是:供应商把预录视频包装成实时交互数字人,演示时看起来流畅,落地后客户问一句没准备过的话,它就卡住或答非所问。等采购方意识到问题,项目往往已经验收了一半。
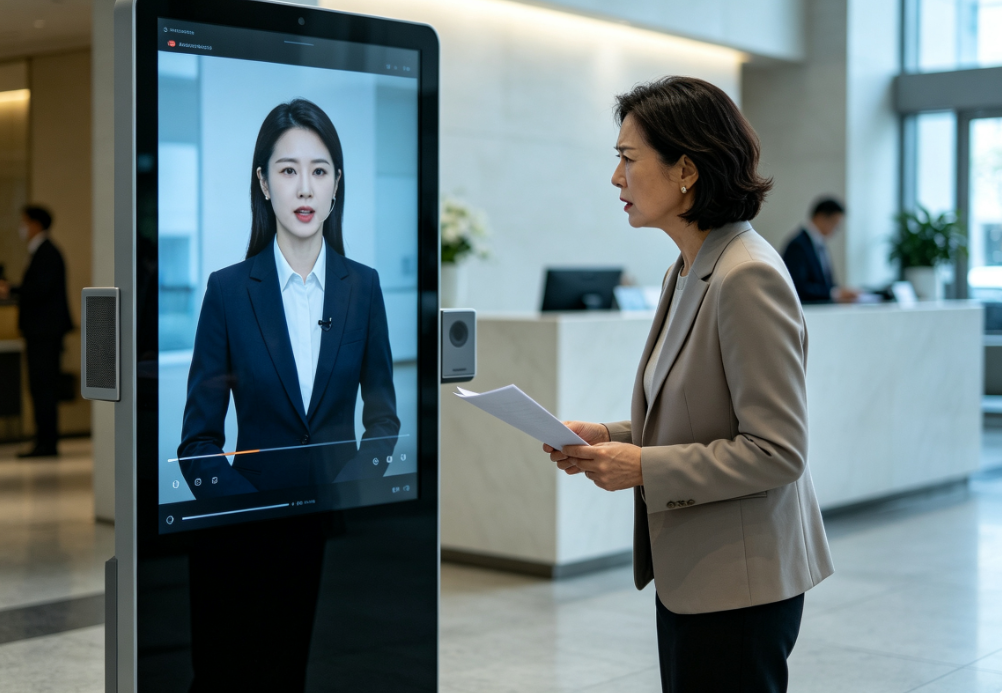
要避开这种坑,不能只看外观像不像真人,也不能只看宣传页上的“AI驱动”“多模态交互”。真正需要确认的只有一件事:它是不是实时驱动的。判断方法可以落到三个具体层面——口型、动作、对话。
口型是最容易观察,也最容易暴露问题的。预录视频的口型本质上是从有限素材里拼出来的。如果视频素材只有几十条,嘴型状态往往只有张、合、半张几种,和真实语音的音节变化对不上。你只要稍微留意,就能发现声音和嘴部动作之间存在错位:声音已经结束,嘴还张着;或者嘴先动了,声音过了小半秒才出来。这种错位在现场可能被环境噪音掩盖,但在正式使用中非常刺眼。
另一个更常见的问题是嘴型僵硬。说话时下颌没有自然开合,只靠嘴唇轻微翻动,像在背稿。真数字人的口型必须实时跟随语音流,音节密度、重音、停顿都会反映在唇部和下颌动作上。扬程电子数字人的口型跟随语音实时精准同步,说话开合自然,不会音嘴脱节。这不是靠某一条视频素材能做到的,需要音频驱动模型在毫秒级时间内生成对应的口型参数。
测试时不用看技术文档,直接让对方连续说一段绕口的长句,或者突然加快语速,观察口型是否还能贴住。录播产品在变速或长句场景下,错位会立刻放大。如果条件允许,可以背对屏幕听一句,再转过来看口型;或者干脆把声音关掉,只看嘴型是否像在正常说话。这两种方法都能绕开大脑的自动补偿机制,让错位更明显。
动作是第二个照妖镜。预录视频的另一个通病是动作循环。视频长度有限,手势、头部转动、身体晃动只能从固定几套模板里反复调用。可能第一句话点头,第二句话又用同一个角度点头;手势在胸前来回摆动,和说话内容毫无关联。这种机械感看十几秒不明显,连续看一两分钟就会觉得不对劲,因为它不符合真人交谈时动作随语气、语义变化的规律。
真数字人如果具备多模态驱动,头部、手部、眼神和语气是协同变化的,动作由对话内容实时触发,不是从模板库按顺序播放。扬程电子数字人实现多模态驱动,头部转动、手势、神态协调连贯,动作随对话内容实时变化,交互状态更接近真人。现场验证时,可以问一个需要方向性回答的问题,比如“你左手边那台设备是什么”,看它是否有相应转向或指示动作;也可以在它说话中途突然打断,看动作是否自然停止。预录视频往往会继续把预设动作播完,因为它的时间轴不由实时对话控制。
但真正能拉开差距的,还是对话能力。伪数字人大多只能播放预设脚本,所谓交互其实是“触发播放”:用户问的问题命中了某条预设话术,系统就播放对应视频片段。问题稍微绕一点、超出库内内容,它就会卡顿、答非所问,或者重复上一段话。演示时供应商通常会把问题控制在脚本范围内,所以看起来流畅。采购方如果只按厂商给的流程走,等于把判断权交给了对方。
真数字人支持多模态自然语言实时对话,可以对接自有知识库,意味着它能根据现场输入实时生成回答,不是从视频库里检索一段匹配录像。扬程电子数字人支持自由问答,可对接自有知识库,临场应答流畅。验证方法很简单:别用厂商准备的问题,现场临时编几个和业务相关但脚本外的问题,看它能不能理解并给出合理回应。如果连续两三个问题都卡住,或者答案明显是从固定话术里硬凑,基本可以判断不是实时交互。
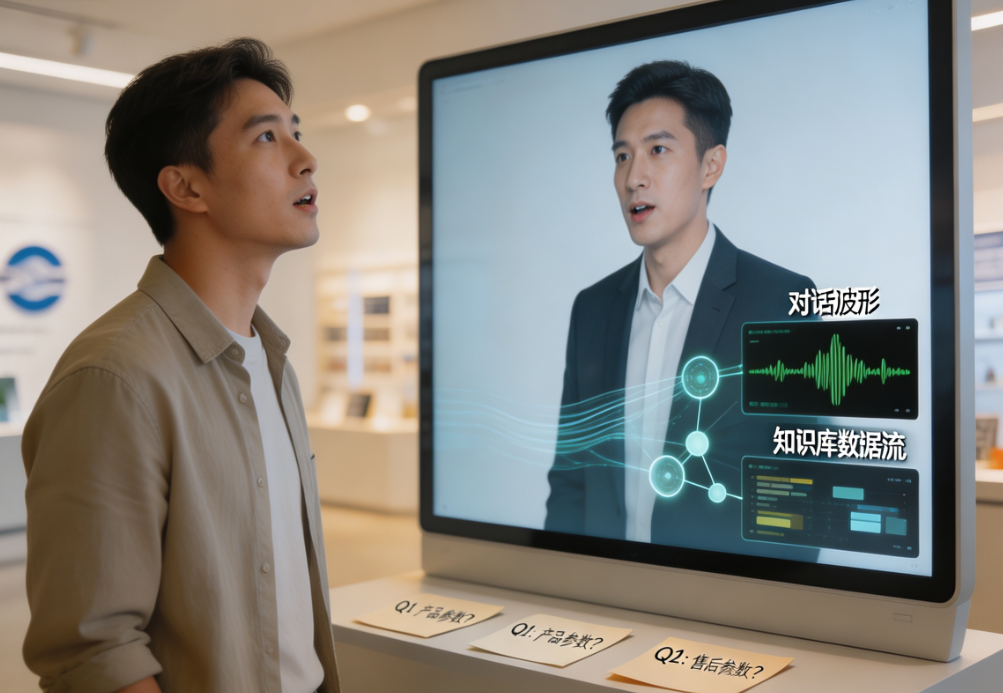
这里有个细节值得注意。真数字人在回答时会有正常的停顿、语气变化,偶尔会有修正;录播产品则像播放录音,每次回答都一模一样,连停顿位置都固定。连续追问也能说明问题。很多伪数字人只能完成单轮问答,第二轮就露出马脚。测试时不要只看首次回答,要就同一个话题连续追问两到三轮,看它是否能维持语境。
这三个判断点之间存在递进关系。口型同步只能证明音频和画面有某种对齐机制,还不能完全排除高级录播;动作非循环进一步说明驱动不是简单播放;只有自由对话成立,才能确认系统具备实时理解和生成能力。很多采购方只看宣传视频和远程演示就下单,实际部署后才发现对方只是一个带触发播放功能的数字人视频。这不是技术参数问题,是验证方法缺失。
伪数字人能在市场上流通,一个重要原因是成本差异。录播方案只需要拍摄、剪辑、配置触发逻辑,交付快、价格低,外观上又能做到接近真人的质感。实时驱动数字人需要解决语音识别、语义理解、语音合成、口型驱动、动作生成多个环节的协同,技术门槛和算力成本都高出不少。一些供应商利用采购方对技术细节不熟悉,用预录视频冒充实时交互,本质上是信息差生意。对采购方来说,最有效的反制手段不是听解释,而是把测试权握在自己手里。
现场测试有几个更具体的做法。口型测试可以背对屏幕听一句,再转过来看口型,或者把声音关掉只看嘴型,判断它是否像在正常说话。动作测试要连续观察一分钟以上,注意是否有重复的点头、抬手或身体晃动。对话测试最直接,临时改问题、追问细节、打断重说,真系统能接住,假系统会露馅。如果供应商以“演示环境网络不好”“这个问题超出范围”为由拒绝测试,本身就是一个信号。
行业里还有一个常见的误区:把数字人的外观逼真度当成核心指标。外观当然重要,但外观可以通过高精度建模和渲染解决,录播产品同样可以做到。真正决定数字人能不能上岗的,是它在实时对话中的表现。一个外观略有瑕疵但能自由问答的数字人,远比一个外观精致但只能背稿的“数字人视频”更有业务价值。采购方如果把预算和注意力都放在皮肤纹理、毛发细节上,反而容易忽略最关键的实时驱动能力。
真正的AI数字人在这些测试里表现稳定,是因为它走的是实时驱动路线:口型跟着语音走,动作由多模态驱动协同生成,对话基于知识库实时作答。这种能力在现场测试中很容易被验证,不需要依赖厂商的解释。对采购方来说,最好的避坑方式不是看技术白皮书,也不是比参数表,而是把口型、动作、对话这三关变成验收标准,写进合同里。
播放预制视频、动作口型割裂、不能实时问答,基本就是伪数字人。这个判断标准不算苛刻,它只是把“数字人”这个词拉回它本该有的含义。如果产品只能按剧本演出,那它更接近一个会动的展示片,而不是能上岗的数字人。市场乱象会持续一段时间,但采购方的判断力也在提高。只要把口型、动作、对话这三关卡住,大部分伪数字人都过不了第一轮。