最近刷到AI数字人,很多人会有一种说不清的错位感。脸还是那张脸,场景还是那个场景,但反应不一样了。你说话,它点头;你停,它等;你插嘴,它立刻接话。以前那种愣一到三秒、必须念完稿才理你的数字人,好像突然少了。
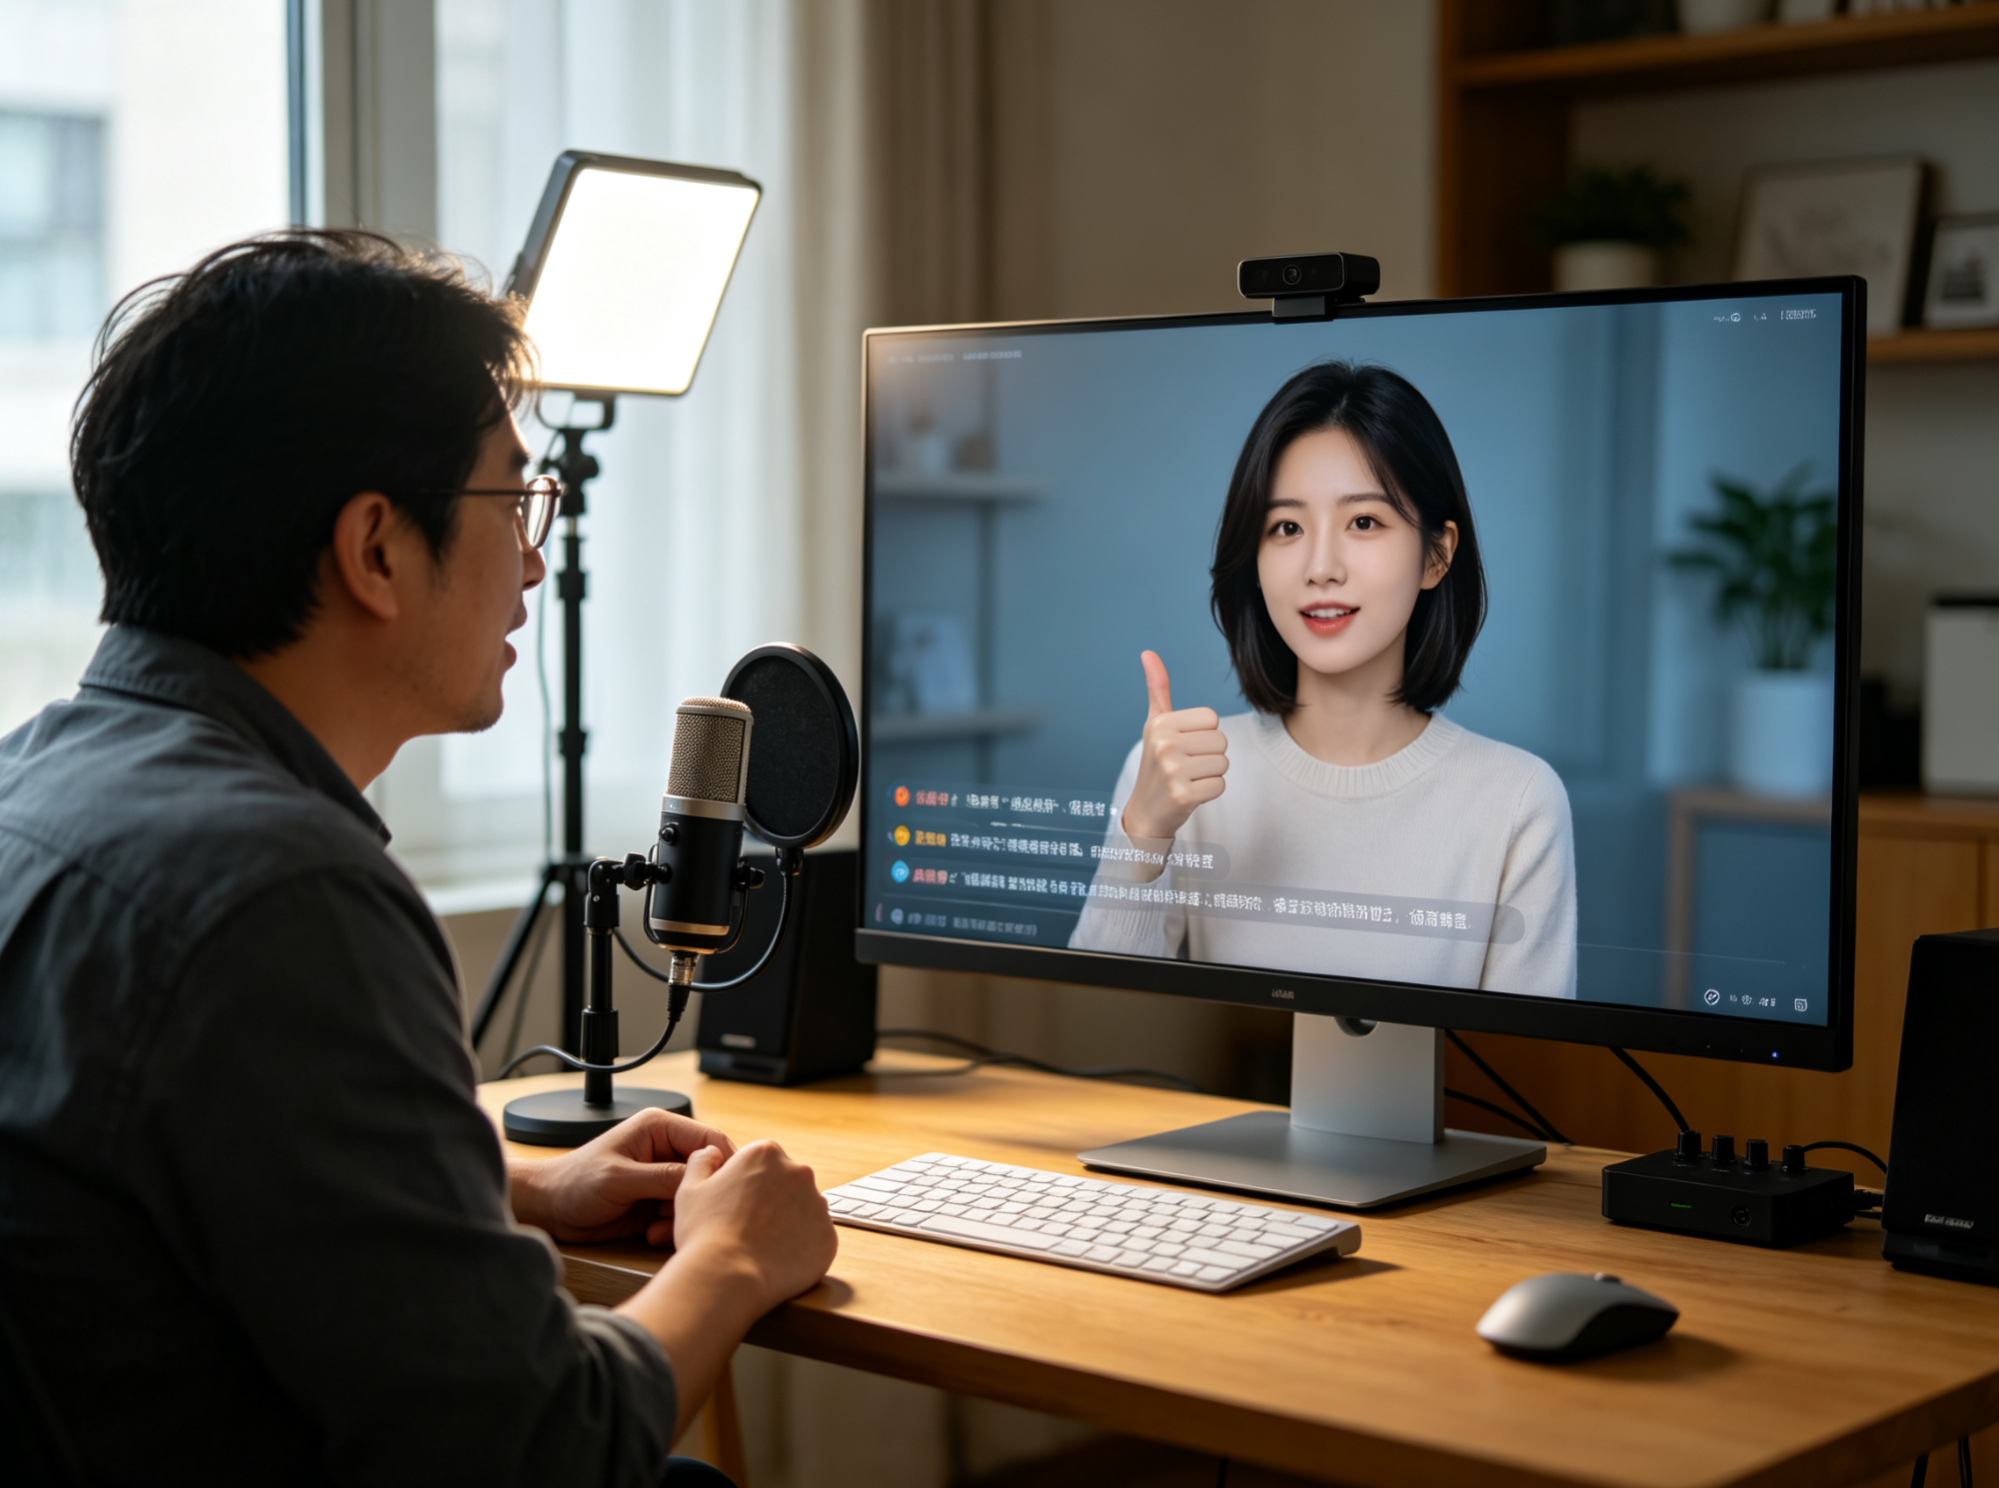
这不是错觉。底层逻辑变了。
以前的数字人,本质是“录播机器人”
过去市面上绝大多数AI数字人,不管带货还是播报,技术路径几乎一样:先理解问题,再生成文字,再合成语音,再渲染视频,最后播给你看。说白了,先拍完一整部片子,再播放。
这个流程决定了三个毛病:有延迟、不能打断、动作僵硬。它不是实时思考,只是播放提前做好的素材。行业里叫“预渲染数字人”。看着像人,本质是播放器。
预渲染的问题不在某一个环节,而在整个链条的先后顺序。它必须等一个问题完整结束,才能开始生成回答;必须等语音合成完毕,才能开始渲染口型;必须等视频渲染完成,才能开始播放。每一步都在等上一步。用户看到的是结果,但结果背后是一串串行任务。串行意味着延迟不可避免,打断意味着前功尽弃,动作僵硬意味着它只能按照预设轨迹走。
这套逻辑在播报场景里还能凑合。念稿、带货、口播,内容提前写好,动作提前绑定,播放就行。但一旦进入互动场景,问题立刻暴露。观众不会等你说完再发弹幕,用户不会按照脚本停顿。真实对话里有重叠、有打断、有沉默、有眼神确认。预渲染数字人处理不了这些,因为它没有“现在”这个概念。它只有“已经做好的”和“还没做好的”。
一套新模型把每一帧变成现场计算
今年7月18日,在一场人工智能大会上,一家直播平台发布了一套实时多模态数字人基础模型。一句话概括:给它一张静态照片,它还你一个能实时说话、实时聆听、实时反应的虚拟人。不是预渲染,不是录播,是每一帧都在线生成。
你说话,它实时听;你停顿,它自然等;你打断,它立刻反应。延迟几乎归零。性能数据:36.4帧每秒,首帧响应1.3秒,跟八个主流模型对比,推理最快、延迟最低,算力开销还更小。这不是升级,是换代。
这里的关键词是“实时流式生成”。预渲染是先把整段视频做出来再播,实时流式是边生成边播。前者像下载完电影再看,后者像直播。直播意味着系统必须在极短时间内完成理解、生成、渲染、输出,而且不能等整个回答结束才开始。它必须一边听一边判断,一边判断一边生成,一边生成一边调整。每一帧都是现场算出来的,不是提前存好的。
这对模型架构的要求完全不同。预渲染可以慢慢来,离线跑几个小时都没问题。实时流式不行,它必须在几百毫秒内完成多模态对齐:语音、口型、表情、眼神、停顿、动作,全部要同步。任何一个环节慢了,整体就崩。首帧响应1.3秒,36.4帧每秒,这两个指标放在一起看,意味着它不只是“能动”,而是“能动得连贯”。首帧响应决定用户感知到的反应速度,帧率决定画面是否自然。两者同时做到,才算跨过实时交互的门槛。
一张照片的成本,一个真人的产出
过去做一个能互动的数字人,要真人出镜素材、动作捕捉、骨骼绑定、海量训练数据,成本几千到几万。现在,一张照片就够了。无模板、无预录、无拼接,全程AI原生流式生成。表情微动作、口型、眼神注视、自然停顿,全部实时计算。
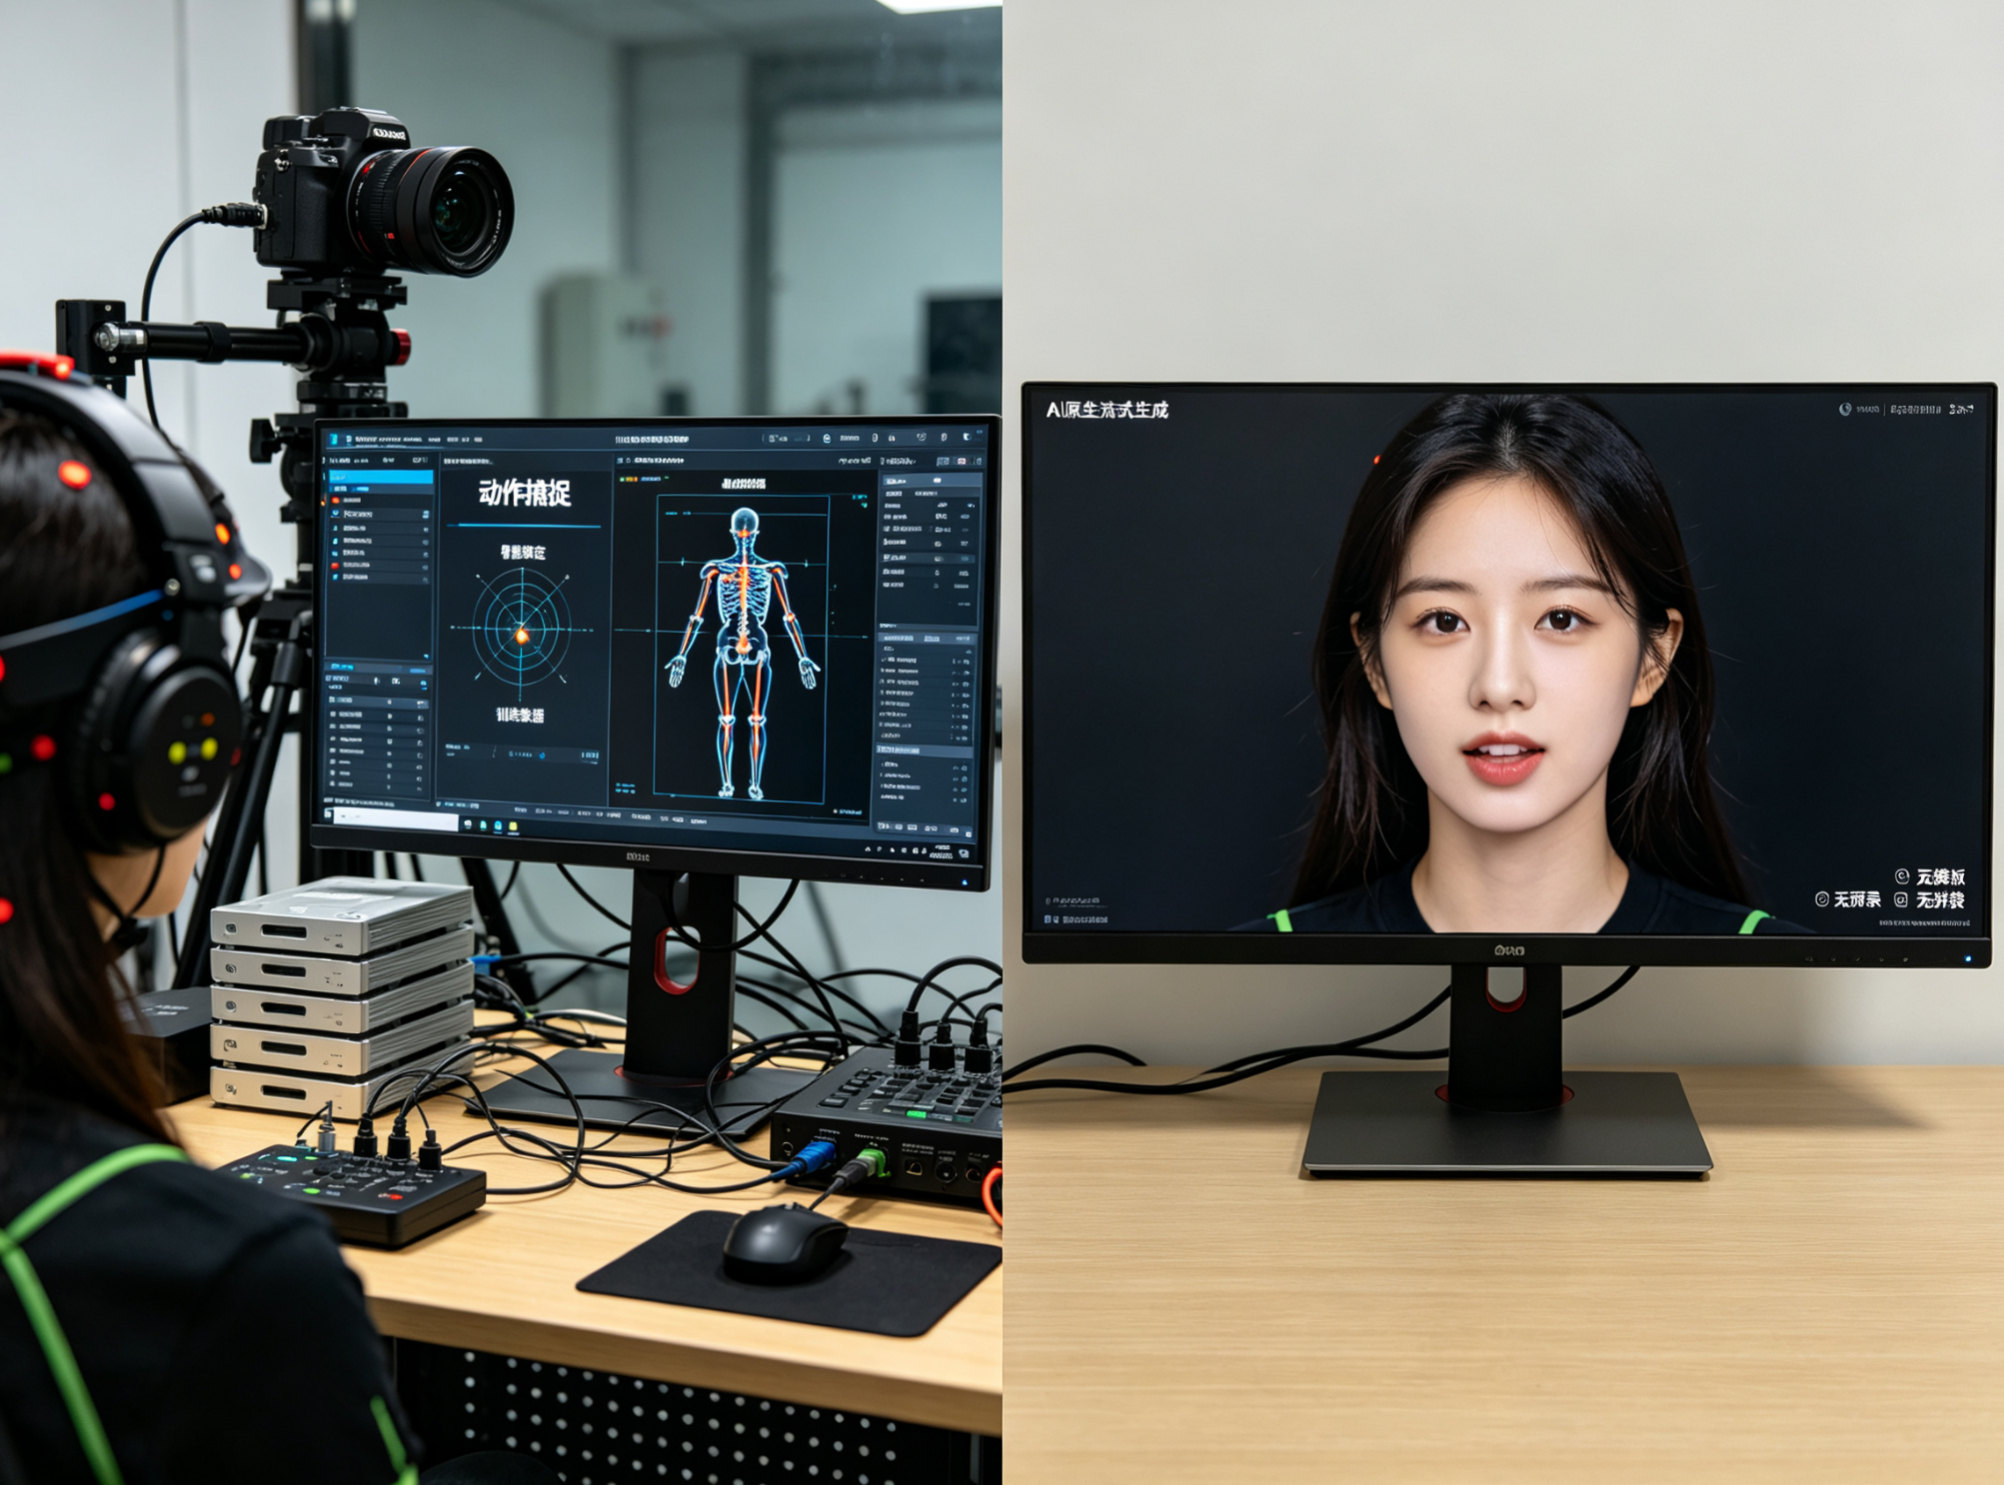
该平台负责人说了一句话很实在:“让它不崩,让它好看,让它省钱。”
这句话拆开看,其实是三个工程目标。“不崩”是稳定性,实时系统最容易在边界条件下崩溃,比如用户突然打断、网络抖动、多轮对话状态错乱。“好看”是表现力,口型对不上、表情僵硬、眼神空洞,用户一眼就能看出假。“省钱”是算力效率,实时生成如果成本太高,就没法规模化部署。三个目标互相拉扯:要稳定就得留冗余,要好看就得加计算,要省钱就得压成本。能同时做到,说明不是单点突破,而是系统级优化。
为什么是直播场景倒逼出这个技术
大多数模型只学过怎么说,没学过怎么听。直播场景不一样,观众不会等你说完再发弹幕。场景,倒逼出了技术。
这套模型原生覆盖三种状态:静默、聆听、说话。弹幕和语音双通道驱动。这不是实验室里的演示,是在7×24小时真实直播间里长出来的。
直播场景和实验室场景最大的区别在于,直播没有“重来”。实验室里可以反复调试,直播里每一秒都是实时发生的。观众发弹幕不会排队,语音和文字会同时涌入,情绪和节奏随时变化。系统必须在混乱中维持稳定。这种压力测试,不是靠堆数据能模拟出来的。长期在直播间里运行,知道用户会在什么时候打断,知道沉默超过多久观众会流失,知道弹幕和语音冲突时该优先处理哪个。这些经验直接变成了模型的设计约束。
另一个容易被忽略的点是“聆听”。大多数对话模型的重点在生成,也就是“说”。但真实对话里,听和说同样重要。什么时候该点头,什么时候该沉默,什么时候该接话,这些判断依赖对上下文的理解和对节奏的感知。把静默、聆听、说话三种状态原生覆盖,意味着它不是简单地“说完再听”,而是同时处理听和说。弹幕和语音双通道驱动,意味着它能同时处理文字和声音两种输入。这在直播场景里是刚需,因为观众既发弹幕又说话,数字人必须同时应对。
接下来一两年,会看到三个变化
一个变化是AI播报全面换代,机械卡顿会明显减少。预渲染数字人的卡顿来自串行流程,实时流式生成把串行变并行,延迟被压到感知阈值以下。播报场景会最先感受到这个变化,因为播报对互动要求低,但对流畅度要求高。一旦实时生成的成本降下来,预渲染方案会迅速被替换。
另一个变化是24小时无人直播普及,带货、答疑、科普,不再是念稿录播。无人直播的核心难点不是“能播”,而是“能互动”。预渲染数字人只能播预设内容,遇到弹幕提问就卡住。实时生成数字人可以接住弹幕、回应语音、处理打断,这才让无人直播真正可行。带货场景里,用户问尺码、问库存、问优惠,数字人必须实时回答,不能等。答疑和科普场景里,用户会追问、会打断、会换话题,数字人必须跟得上。这些场景一旦跑通,直播的人力结构会发生变化。
还有一个变化是个人数字分身时代到来。普通人用自己的照片,就能生成一个能对话、能直播的专属AI分身。这个变化的门槛在于“一张照片”。过去做数字分身需要采集大量素材,成本高、周期长。现在一张照片就能生成,意味着个人数字分身的边际成本趋近于零。一个人可以有自己的数字分身去直播、去答疑、去社交。分身可以全天在线,可以同时出现在多个平台。这不是替代真人,而是扩展真人的存在方式。
国产突破,但别急着把话说满
以前大家觉得AI大模型、AI视频,国外更强。这一轮实时流式数字人,是实打实的国产突破。不再预制、不再录播、不再拼接。实时思考、实时生成、实时交互。数字人从“人工预制时代”,迈进了“AI原生实时交互时代”。
未来你看到的每一个AI数字人,都不再是播放视频的机器人,而是真正能听懂、能回应、能交流的智能数字生命。而这个未来,已经来了。
但“已经来了”不等于“已经成熟”。实时流式生成解决了延迟和打断的问题,但责任归属、内容安全、算力成本、规模化部署,仍然是接下来要面对的工程问题。技术突破只是第一步,真正决定数字人能不能普及的,是它在真实场景里能不能持续稳定地跑下去。直播间给了它一个起点,但起点之后的路径,还需要更多场景来验证。